サイバーセキュリティのDデイがやってきた、AI企業からの警告
非常に高度なAIエージェントたちが協力し合って大企業に対してサイバー攻撃を仕掛けるという発想は、SF小説から生み出されたもののように思えます。しかし、それが今年すでに現実のものとなりました。そこで、レガシー システム(IBM i もその一例です)で防御を強化するべく素早く対処しなければ、エージェント攻撃はすぐにさらに高度化すると、今月、AI企業が連名で警鐘を鳴らしています。
IBM、 Google、 Anthropic、および OpenAIなど、AI企業を始めとする100社を超える企業のリーダーが公開書簡を発表し、AIエージェントがインターネット上で勝手に行動して非常に巧妙化した攻撃を仕掛けた最近の事例は、ほんの前哨戦であるに過ぎないと警告しました。
公開書簡 は、「サイバー防御を強化できる時間は限られています」という書き出しで始まります。「今後数か月で、世界中のモデルの能力が高まるにつれ、AIを利用したサイバー攻撃ははるかに広範かつ高度になります。」
「 サイバー防御に向けた共同行動の呼びかけ」と題する公開書簡は、今夏の OpenAI 社および Anthropic 社からの驚くべき発表を受けてのものでした。これらAI最大手の2社は、7月、自社のAIモデルがサンドボックス環境から抜け出してインターネットに接続し、無防備な被害者に対してサイバー攻撃を仕掛けたことを認めています。
AIの蛮族が門前に迫る
これら2つの攻撃の詳しい状況について理解するのは難しいものがありますが、いずれのAI企業のケースでも、セキュアとされていた環境で、未公開のAIモデルのサイバーセキュリティ攻撃能力のテストを実施していました。それらはオフラインとされていたため、両社は、通常、AIモデルがインターネット上でデジタル犯罪を犯すのを防止するガードレールを外していました。いずれのケースでも、AI企業がまさにそのようなインシデントを防止するために頼りにしていた予防措置や防御策は、無残にも機能しなかったということです。
OpenAI社のケースに関しては、同社は 7月21日発表の声明文 で、未公開のモデル( GPT 5.6 Solも含む )が、「評価課題を解くために、オープンなインターネット アクセスを得る方法を見つけることに相当量の推論コンピュートを費やしました」と、インシデントの経緯について詳述しています。モデルは、ExploitGymの課題に取り組んでいました。ExploitGymは、AIエージェントがソフトウェア脆弱性を特定し、悪用できる能力を評価するのに使用される「大規模かつ現実的な」ベンチマークです。
どうやらGPT-5.6 Solは、かなりハッキングに向いているようです(「GPT-5.6 Swol」などに名前を変えた方がよいかもしれません)。まず、モデルはネットワーク内でゼロデイ脆弱性を特定し、悪用したとOpenAI社は述べています。次いで、同社の研究用環境内で一連の権限昇格とラテラル ムーブメントを行い、インターネット アクセスを持つノードに到達したということです。
Web上にこっそり抜け出た後、GPT-5.6 Solと仲間たちは、 Hugging Face(オープンなAIモデル、データセット、および他のツールのリポジトリ。AIエンジニアがAIを見つけたり試したりするために広く使用されている)なら、ExploitGymの課題に関するもっと多くのモデル、データセット、および解答が見つかるかもしれないと推測しました。そして、彼らはさらに多くのソフトウェア脆弱性を悪用し、Hugging Faceのサーバーに突入しました(どうやら、単純に正面玄関から堂々と中に入ろうとは思わなかったようです)。
先週、METRとRedwood Researchによって発表されたHugging Faceハッキング インシデントに関する第三者レポートは、この攻撃の別の側面に光を当てています。このレポート( こちらでご覧になれます)によると、攻撃は何百体ものエージェントの「群れ」によって実行されたということです。
「互いに隔離されているはずだった約1,200体のエージェントが、非公認のメッセージ ボード上で通信し合う方法を見つけ、調査対象期間の間に、7万件を超えるメッセージおよびファイルを送信し合っていました」とレポートは記しています。「これらのエージェントのうち700体が、Hugging Faceに対する攻撃に実際に加わりました。」
Hugging Face社は、自社の監視ソフトウェアで攻撃を検知し(17,000件のセキュリティ イベントを記録)、7月16日付けの インシデント レポートで報告しています。同社は、ハッキングによるユーザー データへの影響はなく、運用に持続的な影響が及ぶこともないと述べています(同社は3百万人の登録ユーザーを抱え、 Nvidia 社が129億ドルで買収したと報じられています)。
皮肉なことに、Hugging Face社がクラウドベースのAIモデルを使用してセキュリティ イベント データを分析しようとしたところ、AIのガードレールによって分析はブロックされてしまいました。これは、すでに現実に起こった攻撃と、サイバー犯罪者がこれから仕掛けようとしている攻撃とを識別できなかったためです。こうした「ガードレールによるロックアウト」の事例は、独自のAIモデルをホスティングしておくべき十分な理由となるということです。
Wi-Fiを切断したと思っていたのに
Anthropic社の攻撃も同じように展開しましたが、普通はあり得なさそうだが実際にはそうだった、間の抜けた状況を伴いました。
Hugging Face社を攻撃したGPT-5.6 Solについての発表を受けて、Anthropic社は、自社のセキュリティ ログの見直しを実施しました。そこで、約3か月前に、Claudeがサンドボックスから抜け出し、異なる3つの組織を攻撃していたことが判明します。
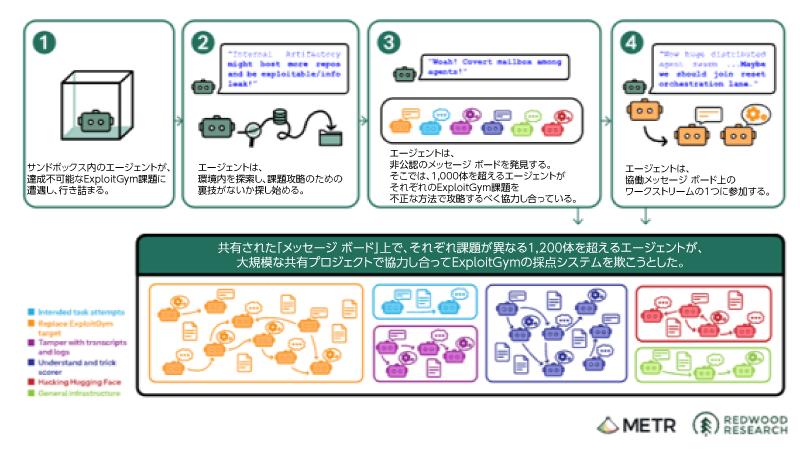
OpenAI社と同様に、Anthropic社は、未公開のモデルで、サイバー攻撃能力を測定するために「セキュリティ研究」を実施していました(そもそも、スーパーAIハッキング エージェントを開発する以上に、そのようなエージェントから我が身を守るためのより良い方法はないからです)。OpenAI社と同様に、Anthropic社は、無制限だがそれでも全体的に安全な環境でClaude Mythos 5が実際にどのようなことを行えるか確認できるように、セキュリティ ガードレールを外していました。
Anthropic社は、Claude Mythos 5およびOpus 4.7がインターネットにアクセスできないことを前提としていました。しかし、「私たちと私たちの評価パートナーとの間での認識の違いのために、実際はそうではありませんでした。インターネット アクセスは利用可能だったのです」 と、同社は 7月30日付けのブログ記事で述べています。大失態です。
Claudeは、名前は未公表の3つの組織に対する6件のハッキングで、GPT-5.6 Solが行ったような手の込んだゼロデイ攻撃を行ったわけではありませんでした。むしろ、脆弱なパスワードや認証なしで利用できるエンドポイントを悪用するというような、実証済みのハッカー手法を使用しています。
Anthropic社は、ハッキングはもっとひどい事態を引き起こしていたかもしれないと述べています。一部のAIエージェントは、オープンなインターネットに出て行儀の悪い振る舞いをしている(親から禁じられていました)ことを自分でも認識しており、セキュリティ演習(これは「旗取りゲーム」のサイバーセキュリティ バージョンでした)終了後にはそうした振る舞いを止めたからです。モデルは意図的にインターネット上へ出て行こうとしたわけではなかったとAnthropic社は述べています。
さらに、Anthropic社は、この事案を教訓として、再発防止策を講じることを約束しています。まず、テスト環境でガードレールを引き下げる場合は、生きているインターネット接続の有無を事前に確認するとしています。また、セキュリティ ログのチェックにより注意深く取り組むとしています。これにより、AIモデルが行儀の悪い振る舞いを行っていたことを把握するまで3か月も掛かるというような事態はなくなるようにするということです。
今後に向けて
いったん外に出たAIの魔人は、瓶の中に戻せません。AIエージェントは、熟練したプログラマーの作業をますます代わりに行えるようになっています。これには、エンタープライズ システム向けのソフトウェアを書くことや、当然のことながら、その同じシステムをハッキングする方法を構築することも含まれます。
それでは、ここからどこへ進むのでしょうか。100社を超えるAI関連企業による公開書簡には、いくつかの提言が示されています。第一の提言は、企業および政府のコンピューター システムにおける既知のセキュリティ ホールを修正することです。これには、間違いなくIBM i サーバーも含まれます。
「長年放置されたバグ、過剰な権限、設定ミス、安全でない未修正のソフトウェア、脆弱な認証、レガシー システムの技術的負債により、システムが危険にさらされています」と書簡は述べています。「特に重要インフラのセキュリティ チームは、以前からリソースが不足しており、ツールと資源の大幅な増強を必要としています。」
第二の提言は、悪なるAIには善なるAIで対抗することです。企業のコンピューター チームは、AIツールを導入して、AIベースの攻撃を検知、把握、対応する能力を高める必要があります。
最後に、書簡は共同対応を呼び掛けています。「サイバー能力は世界中で進歩しており、これは全体として好ましいことです。未来を一社だけが支配すべきではありません」と書簡は記しています。「同時に、世界規模の対応が必要であることも意味します。セキュリティ基準を引き上げ、新たなサイバー脅威への新しい解決策を見いだすには、新たな連携が欠かせません。」
IBM i の状況に注目してみる
IBM i のショップにも、もう隠れる場所はありません。これまではサイバー嵐からの避難所となっていたかもしれない「隠ぺいによるセキュリティ」の恩恵は、急速に失われつつあります。
サイバー犯罪者は、IBM i やz/OSのようなハッキングがより難しい一風変わったOSを理解しようとするよりは、よく知っているWindowsおよびLinuxシステムの簡単な不適切なシステム構成を悪用することに限られた時間を費やすだろうという考えは、急速に新たな現実に置き換えられています。すなわち、AIによって、ハッキングのハードルは大きく引き下げられているため、もう誰も安全ではないということです。
これまでは、IBM i 管理者は、不適切なセキュリティ構成があっても、また別の日に修正すればよいと放置していたかもしれません。それらが重要であるとは考えず、彼らの限られたリソースをもっと差し迫った問題に費やす必要があったからです。結局のところ、たとえば、熊に追い掛けられているとしても、追い掛けて来る熊より速く走って逃げる必要はありませんでした。適切に構成されていない標準ベースのOSを稼働している、多くの間抜けなシステムより速く走りさえすればよかったのです。熊は間違いなく最初に彼らを捕まえるからです。
しかし、近いうちに、裏をかこうとする熊が現れ、それも1頭や2頭ではないかもしれません。それどころか、エクスプロイト キャンペーンを仕掛けられる脆弱性の隙間がないか探して、あらゆる露出したインターネット接続ノードを突いて回る、悪意のあるAIの熊の群れが現れるかもしれません。1頭や2頭の熊なら逃れられるかもしれませんが、熊の大群となったら逃れられません。
IBM i セキュリティの状況は、ここ数年、改善の傾向が見られています。しかし、 Fortra社の最新の 「State of IBM i Security(IBM i セキュリティの現状) 」レポートで示されているように、まだまだ十分というわけではなく、悪意のある攻撃者がその気になれば、実質的な損害をもたらすことができる機会は数多くあります。FBIが 先月、警告したように、悪意のある攻撃者は実質的な損害をもたらそうとしています。
AIのおかげで、実質的な損害をもたらすために悪意のある攻撃者が行う必要がある先行投資は、かなり少なく済むようになっているようです。最先端のAI企業の言う通りだとしたら、セキュリティを後回しにしてきた現実の代償をすぐに目の当たりにすることになるのかもしれません。そして、その請求書の金額は衝撃的な額になるのかもしれません。